Cloud & Microsoft
Azure AI Foundry lernen: RAG-Anwendungen und KI-Agenten sicher entwickeln
Azure AI Foundry lernen: So entwickelst du RAG-Anwendungen und KI-Agenten mit sicherem Datenzugriff, Evaluierung und Kostenkontrolle.
 KI-generiert
Ein Fachbereich möchte einen KI-Assistenten, der Fragen zu internen Richtlinien, Projektunterlagen und technischen Handbüchern beantwortet. Der erste Prototyp liefert nach wenigen Stunden überzeugende Antworten. Doch sobald echte Dokumente, vertrauliche Informationen und mehrere Nutzergruppen ins Spiel kommen, reichen ein Chatfenster und ein Sprachmodell nicht mehr aus. Genau an diesem Punkt beginnt die praktische Arbeit mit Azure AI Foundry.
Azure AI Foundry bietet Teams eine Arbeitsumgebung, um KI-Anwendungen mit Sprachmodellen zu entwickeln, zu testen und kontrolliert bereitzustellen. Für Unternehmen sind dabei vor allem zwei Anwendungsfälle relevant: RAG-Anwendungen, die Antworten auf interne Wissensquellen stützen, und KI-Agenten, die innerhalb klarer Grenzen Werkzeuge und Unternehmenssysteme nutzen. Beides kann wertvolle Arbeit beschleunigen, verlangt aber saubere Architekturentscheidungen und Kompetenzen in Entwicklung, Cloud-Betrieb und Sicherheit.
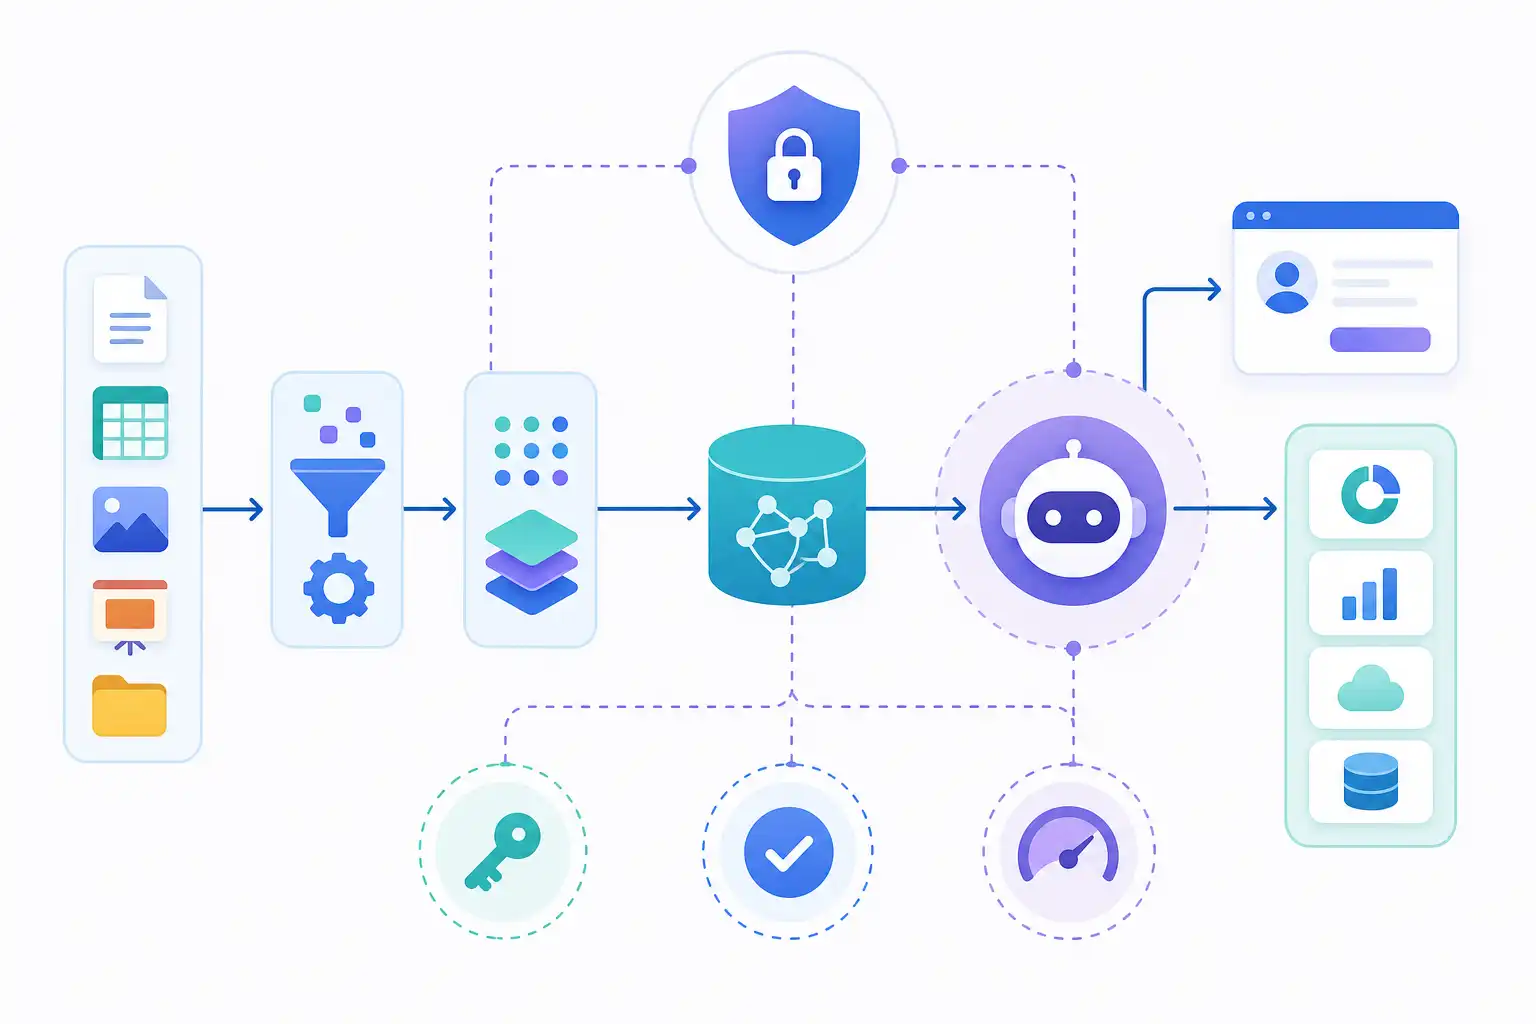
Infografik zu Azure AI Foundry lernen: RAG-Anwendungen und KI-Agenten sicher entwickeln (KI-generiert).
Was Azure AI Foundry für Teams praktisch leistet
Azure AI Foundry bündelt Funktionen rund um Modelle, Prompts, Evaluierungen, Sicherheitsmechanismen und Anwendungsentwicklung. Teams können unterschiedliche Modelle erproben, Eingaben und Ausgaben prüfen sowie Anwendungen schrittweise vom Experiment in einen geregelten Betrieb überführen.
Wichtig ist die Abgrenzung: Azure AI Foundry ersetzt weder ein durchdachtes Berechtigungskonzept noch eine Datenstrategie. Die Plattform hilft beim Aufbau und Betrieb, entscheidet aber nicht, welche Dokumente ein Nutzer sehen darf, welche Werkzeuge ein Agent ausführen kann oder wann eine Antwort fachlich ausreichend ist.
In der Praxis arbeiten meist mehrere Rollen zusammen:
- Fachverantwortliche definieren Fragen, Zielgruppen und Qualitätskriterien.
- Entwickler bauen RAG-Pipelines, Schnittstellen und die Anwendungslogik.
- Cloud- und Plattformteams verantworten Identitäten, Netzwerke, Bereitstellung und Überwachung.
- Security- und Datenschutzverantwortliche prüfen Datenflüsse, Berechtigungen und Protokollierung.
- Betriebsteams beobachten Nutzung, Fehler, Kosten und Änderungen an Datenquellen oder Modellen.
Je früher diese Perspektiven zusammenkommen, desto weniger wird aus einem gelungenen Demonstrator später ein schwer wartbares Einzellösung.
RAG: Interne Wissensquellen gezielt nutzbar machen
RAG steht für „Retrieval-Augmented Generation“. Die Anwendung sucht vor der Antwort relevante Textstellen aus freigegebenen Wissensquellen. Diese Fundstellen werden zusammen mit der Nutzerfrage an das Modell übergeben. Das Modell formuliert daraus eine Antwort, idealerweise mit nachvollziehbaren Quellenhinweisen.
Der Ansatz ist sinnvoll, weil interne Dokumente nicht in ein Modelltraining übernommen werden müssen, damit sie beantwortbar werden. Zugleich bleibt Wissen aktualisierbar: Wird eine Richtlinie geändert, muss der Index aktualisiert werden, statt ein neues Modell zu trainieren.
Eine belastbare RAG-Anwendung besteht typischerweise aus mehreren Schritten:
- Dokumente werden aus freigegebenen Quellen übernommen.
- Inhalte werden bereinigt, in sinnvolle Abschnitte zerlegt und mit Metadaten versehen.
- Ein Suchindex speichert Text, Vektorrepräsentationen und Filterinformationen.
- Die Anwendung sucht zu einer Frage passende Abschnitte.
- Das Modell erhält nur die relevanten Inhalte sowie klare Antwortregeln.
- Die Antwort zeigt, auf welchen Dokumenten oder Abschnitten sie beruht.
Die Qualität hängt dabei selten nur vom gewählten Modell ab. Häufig sind schlechte Dokumentstruktur, unvollständige Metadaten oder ungünstige Abschnittsgrößen die eigentliche Ursache für unzuverlässige Antworten. Wenn etwa ein Handbuch in zufällige Textblöcke geteilt wird, fehlen Zusammenhänge. Werden Dokumentversion, Freigabestatus oder Fachbereich nicht als Metadaten gepflegt, kann die Suche veraltete oder unpassende Inhalte liefern.
Berechtigungen gehören in die Suche, nicht nur in die Oberfläche
Ein kritischer Fehler besteht darin, dass die Benutzeroberfläche zwar eine Anmeldung verlangt, der Suchindex aber alle Inhalte ohne Berechtigungsprüfung ausliefert. Dann kann ein Nutzer Antworten zu Dokumenten erhalten, auf die er im Ursprungssystem keinen Zugriff hätte.
Deshalb muss die RAG-Architektur den Datenzugriff konsequent abbilden. Ein mögliches Muster ist, Dokumente oder Dokumentabschnitte mit Gruppen, Rollen, Mandanten oder Vertraulichkeitsmerkmalen zu versehen. Bei jeder Suche werden nur Inhalte berücksichtigt, die zur Identität des angemeldeten Nutzers passen.
Microsoft Entra ID spielt dabei für Identitäten, Gruppen und Zugriffssteuerung eine zentrale Rolle. Wie sich MFA, Gerätezustand und Risiken für den Zugriff kombinieren lassen, zeigen wir auch in unserem Beitrag zu Microsoft Entra Conditional Access. Für eine KI-Anwendung gilt zusätzlich: Die Anwendung selbst braucht möglichst eng begrenzte technische Identitäten für Datenquellen, Indizes und weitere Azure-Dienste.
KI-Agenten: Vom Chatbot zum kontrollierten Handeln
Ein KI-Agent beantwortet nicht nur Fragen, sondern kann abhängig von seiner Aufgabe Werkzeuge einsetzen. Beispiele sind die Suche in einem Ticketsystem, das Abrufen eines Systemstatus, das Erstellen eines Entwurfs oder das Vorbereiten einer Anfrage in einem Fachsystem.
Das klingt nach einer kleinen Erweiterung, ist technisch und organisatorisch aber ein großer Schritt. Ein Agent verbindet die Unvorhersehbarkeit natürlicher Sprache mit konkreten Aktionen. Deshalb braucht jede Werkzeuganbindung eine klare fachliche und technische Begrenzung.
Für den Einstieg empfehlen wir, Aktionen nach Risiko zu staffeln:
| Stufe | Beispiel | Erforderliche Kontrolle |
|---|---|---|
| Lesen | Ticketstatus oder Dokumente abrufen | Berechtigung prüfen, Quellen anzeigen |
| Vorschlagen | Antwortentwurf oder Änderungsplan erstellen | Mensch prüft vor Übernahme |
| Vorbereiten | Ticket oder Bestellung als Entwurf anlegen | Vorschau und explizite Freigabe |
| Ausführen | Konfiguration ändern oder Auftrag absenden | Enge Rechte, Bestätigung, Protokollierung |
Ein Agent sollte keine weitreichenden Administrationsrechte erhalten, nur weil er theoretisch viele Aufgaben erledigen könnte. Besser ist ein Werkzeug pro klar umrissener Fähigkeit, etwa „offene Tickets eines Teams lesen“ statt „vollständiger Zugriff auf das ITSM-System“.
Wenn Agenten externe Tools und Datenquellen über MCP anbinden, sind zusätzliche Schutzmaßnahmen erforderlich. Dazu gehören die Prüfung des Servers, eine eindeutige Authentisierung, minimale Berechtigungen und eine Kontrolle der übermittelten Inhalte. Konkrete Risiken und Schutzmuster erläutern wir im Ratgeber MCP-Server sicher entwickeln.
Qualität messbar evaluieren, statt nur gute Demos zu zeigen
Eine einzelne überzeugende Antwort beweist nicht, dass eine KI-Anwendung zuverlässig ist. Teams brauchen einen festen Satz realistischer Testfragen. Dieser sollte typische, schwierige und unerwünschte Situationen enthalten.
Für RAG-Anwendungen sind unter anderem diese Fragen entscheidend:
- Findet die Suche die richtigen Quellen?
- Bezieht sich die Antwort tatsächlich auf die gefundenen Inhalte?
- Werden Unsicherheiten klar benannt?
- Verweist die Anwendung nachvollziehbar auf Quellen?
- Lehnt sie Fragen ab, wenn keine freigegebene Grundlage vorhanden ist?
- Bleiben Antworten auch bei missverständlichen oder unvollständigen Fragen sicher?
Bei Agenten kommen weitere Prüfungen hinzu: Wählt der Agent das richtige Werkzeug, übergibt er nur erforderliche Daten, bleibt er innerhalb seiner Rechte und verlangt er vor kritischen Aktionen eine Bestätigung?
Diese Evaluierung sollte nicht nur vor dem ersten Rollout stattfinden. Änderungen an Prompts, Modellen, Suchlogik, Dokumentbeständen oder Werkzeugen können Ergebnisse verändern. Deshalb gehören Testfälle in den Entwicklungsprozess und in jede relevante Änderung.
Für Teams, die Microsoft 365 Copilot parallel einsetzen, ist die Berechtigungsbereinigung besonders wichtig. Denn auch dort entscheidet die vorhandene Informationsarchitektur darüber, was Nutzer finden können. Unser Beitrag Microsoft 365 Copilot sicher einführen zeigt, warum Berechtigungen und Datenzugriff vor dem breiten Einsatz geprüft werden sollten.
Kosten von Beginn an sichtbar machen
KI-Kosten entstehen nicht nur durch die Ausgabe eines Modells. Bei RAG kommen Indexierung, Speicherung, Suchvorgänge, Einbettungsmodelle, Netzwerk und Protokollierung hinzu. Bei Agenten erhöhen Werkzeugaufrufe, längere Kontextfenster und mehrstufige Abläufe den Verbrauch.
Eine gute Kostenkontrolle beginnt mit technischen Leitplanken:
- Verwende für jede Anwendung und Umgebung eindeutige Tags.
- Trenne Entwicklung, Test und Produktion.
- Begrenze die Größe übergebener Kontexte auf relevante Inhalte.
- Miss Modellaufrufe, Antwortzeiten, Suchtreffer und Werkzeugaufrufe.
- Definiere Budgets und prüfe auffällige Nutzung zeitnah.
- Vergleiche Modelle und Promptvarianten anhand derselben Testfälle.
Besonders wichtig ist die Verbindung von Kosten und Qualität. Ein günstigeres Modell ist keine gute Wahl, wenn es deutlich mehr Nacharbeit erzeugt. Umgekehrt ist ein großes Modell nicht automatisch sinnvoll, wenn ein kleineres Modell für klar strukturierte Aufgaben ähnliche Ergebnisse liefert. Für das Zusammenspiel aus Tags, Budgets und Verbrauchsdaten findest du praktische Hinweise in unserem Artikel Azure-Kosten mit FinOps optimieren.
Welches Wissen Entwicklung und Betrieb brauchen
Für einen tragfähigen Einsatz reichen Grundlagen im Prompting nicht aus. Entwickler sollten Datenaufbereitung, Suchverfahren, Schnittstellen, Fehlerbehandlung und Evaluierung beherrschen. Cloud-Teams brauchen Wissen zu Azure-Ressourcen, Identitäten, Netzwerken, Monitoring und Kostensteuerung. Fachbereiche müssen Quellen verantworten und Qualitätsmaßstäbe festlegen.
Eine sinnvolle Lernreihenfolge kann so aussehen:
- Grundlagen zu Azure, Identitäten und sicheren Zugriffswegen schaffen.
- RAG mit einer begrenzten, gut gepflegten Wissensquelle umsetzen.
- Testfragen, Quellenanzeige und Ablehnungsregeln verbindlich einführen.
- Kosten und technische Telemetrie auswerten.
- Erst danach Agenten mit risikoarmen Lesewerkzeugen ergänzen.
- Schreibende oder auslösende Aktionen nur mit Freigaben und klarer Betriebsverantwortung einführen.
Für Teams, die ihre Cloud-Rolle grundsätzlich schärfen möchten, kann auch unser Überblick Cloud-Zertifizierung: Azure oder AWS lernen bei der Orientierung helfen. Passende Seminare und Termine findest du bei uns auf cmt.de.
Fazit: Erst kontrollierbar, dann skalierbar
Azure AI Foundry kann Teams dabei unterstützen, interne Informationen in hilfreiche KI-Anwendungen zu überführen. Der Erfolg entscheidet sich jedoch nicht am ersten Prototypen. Entscheidend sind freigegebene Datenquellen, durchgesetzte Berechtigungen, nachvollziehbare Antworten, wiederholbare Tests und ein Betrieb, der Kosten sowie Risiken im Blick behält.
Beginne deshalb mit einem eng abgegrenzten Anwendungsfall, einer überschaubaren Nutzergruppe und klaren Erfolgskriterien. Wenn RAG zuverlässig arbeitet und Verantwortlichkeiten geklärt sind, können KI-Agenten schrittweise dazukommen. So entsteht aus einer überzeugenden Demo eine Anwendung, die im Unternehmensalltag tatsächlich nutzbar und beherrschbar bleibt.
Nächster Schritt
Passenden Kurs zu Cloud & Microsoft finden.
Feste Termine, erfahrene Trainer, Präsenz in München und Durchführungsgarantie. Buchen kannst du direkt auf cmt.de.
Weiterlesen
Mehr aus Cloud & Microsoft
-
 KI Microsoft Entra Private Access einführen: VPN-Ablösung mit Global Secure Access planen 8 Min. Lesezeit
-
 KI Copilot Studio Agents im Unternehmen einführen: Governance, Datenzugriff und Freigaben 8 Min. Lesezeit
-
 KI Exchange Server Subscription Edition migrieren: Praxisplan für Exchange 2019 8 Min. Lesezeit