IT-Security
NIS2 umsetzen: Praxis-Checkliste für IT-Administratoren
NIS2 umsetzen: Mit dieser Praxis-Checkliste stärkst du Asset-Inventar, MFA, Patches, Backups, Logging und Incident Response.
 KI-generiert
Montagmorgen, ein kritischer Server meldet ungewöhnliche Anmeldeversuche. Im Ticketsystem fehlt jedoch ein klarer Eigentümer, die letzte Sicherung ist nicht getestet und niemand kann sofort sagen, welche Fachanwendung betroffen ist. Genau an solchen Stellen entscheidet sich, ob Sicherheitsvorgaben im Alltag tragen. NIS2 umzusetzen bedeutet für Admin-Teams deshalb nicht, Dokumente abzulegen. Es bedeutet, technische Abläufe so aufzubauen, dass du Risiken erkennst, Vorfälle beherrschst und Maßnahmen nachweisen kannst.
Die NIS2-Richtlinie fordert von betroffenen Organisationen ein risikobasiertes Sicherheitsniveau. Welche Anforderungen für dein Unternehmen konkret gelten, klärst du mit den verantwortlichen Stellen für Recht, Informationssicherheit und Geschäftsleitung. Für den IT-Betrieb ist die Richtung aber eindeutig: Du brauchst Transparenz über Systeme, belastbare Schutzmechanismen, überwachte Prozesse und eine eingeübte Reaktion auf Sicherheitsvorfälle.
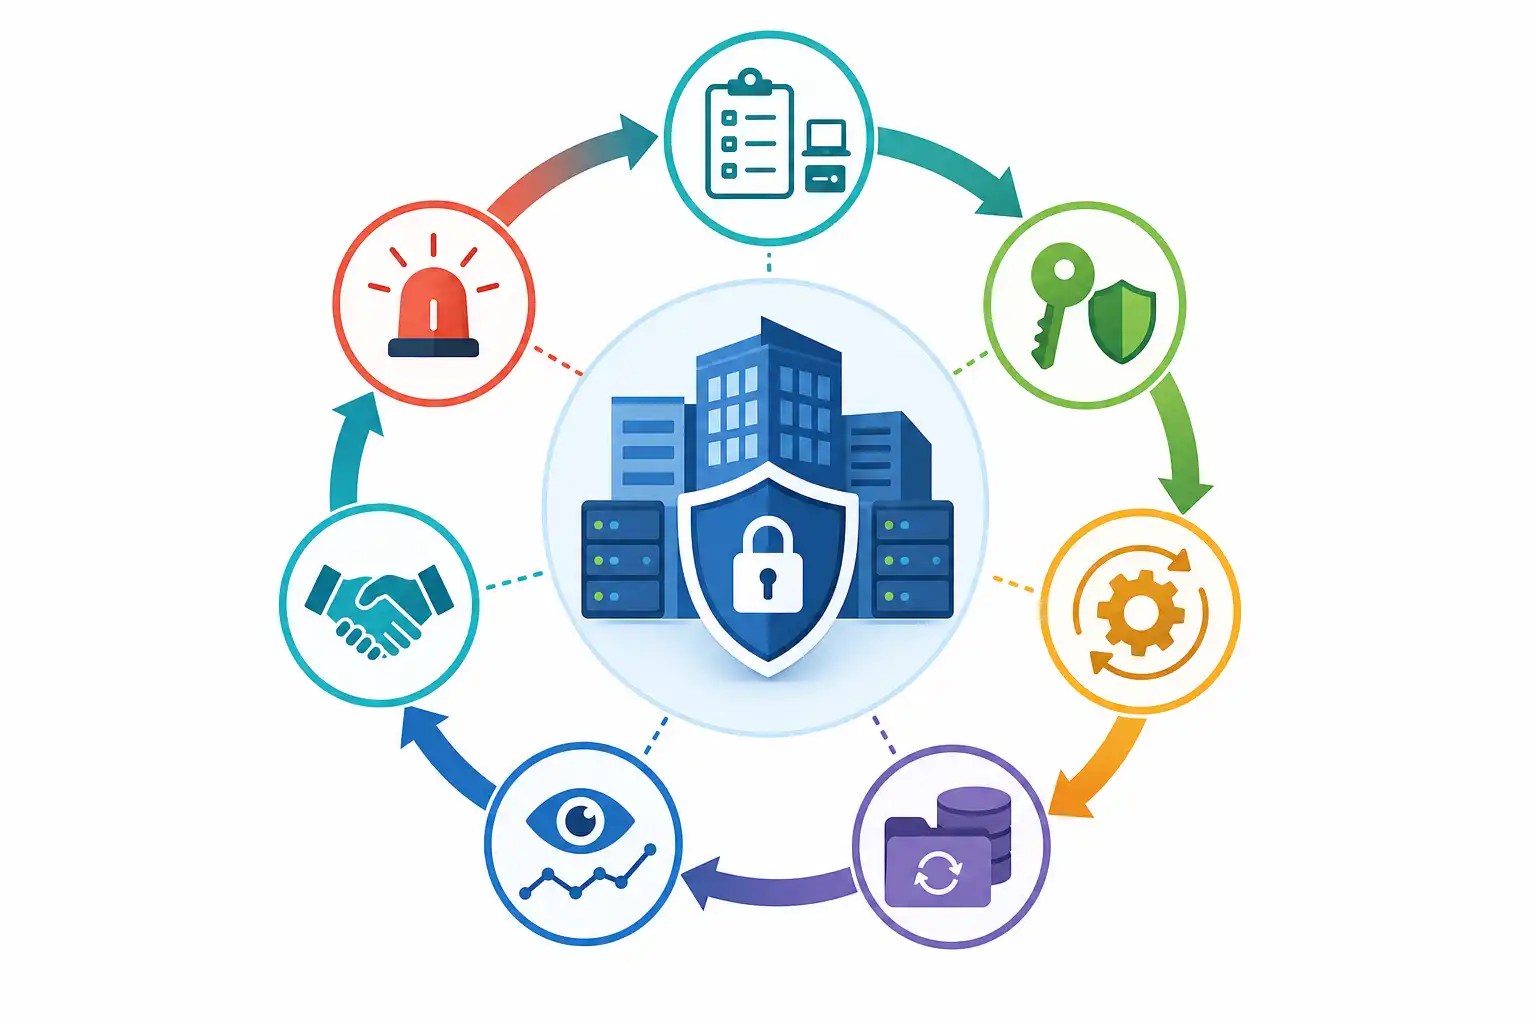
Infografik zu NIS2 umsetzen: Praxis-Checkliste für IT-Administratoren (KI-generiert).
Mit einem vollständigen Asset-Inventar beginnen
Du kannst nur schützen, was du kennst. Ein Asset-Inventar ist deshalb keine einmalige Excel-Liste, sondern ein gepflegter Datenbestand für den technischen Betrieb. Es umfasst nicht nur Server und Clients, sondern auch Cloud-Dienste, Netzwerkkomponenten, virtuelle Maschinen, Container, mobile Geräte, administrative Konten, Schnittstellen und Software.
Für jedes wichtige Asset sollten mindestens diese Informationen verfügbar sein:
- Eindeutiger Name und technischer Standort
- Verantwortliche Person oder verantwortliches Team
- Zweck und Schutzbedarf des Systems
- Betriebssystem, Version und Patchstand
- Installierte kritische Anwendungen und Abhängigkeiten
- Netzwerkzonen, IP-Adressen und erreichbare Dienste
- Sicherungsart, Sicherungsziel und Wiederherstellungsziel
- Lieferant, Wartungsvertrag und externe Zugriffswege
Besonders wichtig sind Abhängigkeiten. Eine Anwendung kann technisch verfügbar sein und trotzdem ausfallen, wenn etwa die zentrale Anmeldung, ein Zertifikatsdienst, DNS, eine Datenbank oder ein Cloud-Speicher nicht erreichbar ist. Dokumentiere daher nicht nur einzelne Komponenten, sondern auch die Services, die sie gemeinsam bereitstellen.
Automatisierte Inventarisierung hilft, ersetzt aber keine Verantwortung. Tools können Endpunkte, Softwarestände und Konfigurationen erkennen. Das Team muss jedoch bewerten, welches Asset geschäftskritisch ist, welche Daten verarbeitet werden und wer Entscheidungen treffen darf.
Identitäten schützen: MFA, Rollen und Admin-Konten
Gestohlene Zugangsdaten gehören zu den häufigsten Einstiegspunkten bei Sicherheitsvorfällen. Mehrfaktor-Authentifizierung, kurz MFA, ist deshalb für Fernzugriffe, Cloud-Anwendungen, administrative Konten und besonders sensible Systeme ein zentraler Baustein.
Führe MFA nicht nur für einzelne Anwendungen ein. Prüfe den gesamten Anmeldeweg:
- VPN, Remote Desktop und Bastion Hosts
- Administrationsportale für Cloud- und Netzwerkdienste
- E-Mail, Kollaborationsplattformen und Dateifreigaben
- Identitätsverwaltung und Verzeichnisdienste
- Notfallzugänge für Störungen und Wiederanlauf
Admin-Konten dürfen nicht für E-Mail, Webrecherche oder tägliche Büroarbeit verwendet werden. Trenne persönliche Benutzerkonten, privilegierte Konten und technische Dienstkonten sauber voneinander. Vergib Rechte nach Rollen und Aufgaben, nicht nach Gewohnheit. Wenn jemand das Team wechselt oder das Unternehmen verlässt, müssen Berechtigungen zeitnah angepasst werden.
Plane auch Ausnahmen. Es gibt Systeme, bei denen moderne MFA nicht direkt möglich ist, etwa ältere Fachanwendungen oder Geräte mit eingeschränkter Authentifizierung. Solche Ausnahmen brauchen dokumentierte Kompensationsmaßnahmen, beispielsweise einen streng segmentierten Zugriff, einen Jump Host, zusätzliche Netzwerkregeln und engmaschige Protokollierung. Eine Ausnahme ohne Ablaufdatum wird schnell zum dauerhaften Risiko.
Patchmanagement als steuerbaren Prozess etablieren
Ein ungeplanter Patch kann Störungen verursachen, ein fehlender Patch kann Angriffe ermöglichen. Ein wirksames Patchmanagement löst diesen Konflikt nicht durch Bauchgefühl, sondern durch feste Abläufe und nachvollziehbare Prioritäten.
Lege fest, wie ihr Schwachstellen bewertet. Berücksichtigt dabei nicht nur die technische Bewertung einer Lücke, sondern auch ihre praktische Relevanz: Ist das System aus dem Internet erreichbar? Gibt es bereits bekannte Angriffe? Wird ein kritischer Geschäftsprozess beeinträchtigt? Gibt es einen funktionierenden Workaround?
Ein praxistauglicher Prozess umfasst diese Schritte:
- Sicherheitsmeldungen von Herstellern und eingesetzten Plattformen beobachten.
- Betroffene Systeme anhand des Asset-Inventars identifizieren.
- Kritikalität, Erreichbarkeit und mögliche Auswirkungen bewerten.
- Updates in einer geeigneten Testumgebung prüfen.
- Rollout, Wartungsfenster und Rückfalloptionen planen.
- Umsetzung technisch kontrollieren und dokumentieren.
- Offene Risiken, Ausnahmen und Ersatzmaßnahmen nachverfolgen.
Nicht jedes System kann sofort aktualisiert werden. Für unvermeidbare Verzögerungen brauchst du eine klare Entscheidung, eine begründete Risikobewertung und befristete Schutzmaßnahmen. Dazu gehören beispielsweise zusätzliche Filterregeln, die Abschaltung nicht benötigter Dienste oder eine engere Überwachung. Wichtig ist, dass Ausnahmen sichtbar bleiben und regelmäßig überprüft werden.
Backups so aufbauen, dass Wiederherstellung gelingt
Eine Sicherung ist erst dann wertvoll, wenn du daraus verlässlich wiederherstellen kannst. Viele Teams prüfen Backup-Jobs, testen aber keine Wiederherstellung unter realistischen Bedingungen. Für einen belastbaren Betrieb gehören beides zusammen.
Definiere für kritische Services, welche Daten gesichert werden, wie häufig Sicherungen erfolgen, wie lange sie aufbewahrt werden und wie schnell eine Wiederherstellung möglich sein muss. Berücksichtige dabei Datenbanken, Konfigurationen von Netzwerkgeräten, Schlüsselmaterial, virtuelle Maschinen, Cloud-Daten und die Dokumentation für den Wiederanlauf.
Schütze Sicherungen vor Manipulation und Verschlüsselung. Dafür eignen sich getrennte Berechtigungen, separate Backup-Konten, unveränderbare Speicheroptionen und räumlich oder logisch getrennte Kopien. Wer ein Produktivsystem kompromittiert, darf nicht automatisch die Sicherungen löschen können.
Teste Wiederherstellungen regelmäßig. Dokumentiere dabei nicht nur, ob ein einzelnes File zurückgespielt werden konnte. Prüfe auch, ob eine Anwendung nach der Wiederherstellung konsistent startet, ob Abhängigkeiten funktionieren und ob die benötigte Zeit realistisch ist.
| Prüffrage | Nachweis im Betrieb |
|---|---|
| Sind alle kritischen Systeme in der Sicherung enthalten? | Abgleich von Asset-Inventar und Backup-Berichten |
| Können Sicherungen getrennt vom Produktivsystem geschützt werden? | Berechtigungskonzept und Konfigurationsprüfung |
| Ist die Wiederherstellung getestet? | Testprotokoll mit Ergebnis, Dauer und Verbesserungen |
| Gibt es klare Wiederanlaufprioritäten? | Dokumentierter Wiederanlaufplan für Services |
Logging und Monitoring für die Ursachenanalyse nutzen
Nach einem Vorfall ist es zu spät, grundlegende Protokollierung einzurichten. Du brauchst Logs, um Auffälligkeiten zu erkennen, Abläufe nachzuvollziehen und technische Entscheidungen zu belegen. Dabei geht es nicht darum, möglichst viele Daten zu sammeln. Entscheidend sind relevante Ereignisse, eine verlässliche Zeitbasis und eine Auswertung, die tatsächlich stattfindet.
Protokolliere insbesondere Anmeldungen, fehlgeschlagene Login-Versuche, Änderungen an privilegierten Berechtigungen, Konfigurationsänderungen, sicherheitsrelevante Ereignisse auf Endpunkten sowie Zugriffe von externen Dienstleistern. Zentralisiere wichtige Logs, damit sie nicht nur auf einem kompromittierten System liegen. Schütze sie vor unberechtigter Veränderung und lege angemessene Aufbewahrungszeiten fest.
Definiere konkrete Alarme. Beispiele sind eine ungewöhnlich hohe Zahl fehlgeschlagener Anmeldungen, die Anlage eines neuen globalen Administrators, eine Anmeldung aus einem atypischen Land oder die Abschaltung eines Sicherheitsdienstes. Jeder Alarm braucht einen Empfänger, eine Reaktionsanweisung und eine Entscheidung darüber, wann ein Incident eröffnet wird.
Lieferanten-Zugriffe kontrollieren und begrenzen
Externe Dienstleister benötigen häufig Zugriff auf Systeme, etwa für Wartung, Support oder Fehleranalyse. Diese Zugriffe dürfen nicht als dauerhafte Hintertür bestehen bleiben. Erfasse, welcher Lieferant auf welche Umgebung zugreift, über welchen Weg die Verbindung erfolgt und wer intern die Verantwortung trägt.
Setze auf namentliche Konten statt gemeinsamer Zugangsdaten. MFA, zeitlich begrenzte Freigaben und klar segmentierte Zugangswege reduzieren das Risiko erheblich. Idealerweise erfolgt der Zugriff über einen kontrollierten Einstiegspunkt, der Sitzungen nachvollziehbar protokolliert. Prüfe Berechtigungen regelmäßig, insbesondere nach Vertragsänderungen, Systemmigrationen oder Personalwechseln beim Dienstleister.
Auch Lieferanteninformationen gehören in euren Incident-Prozess. Wenn ein kritisches Produkt betroffen ist, muss klar sein, wen du beim Hersteller erreichst, welche Vertragsdaten benötigt werden und wie technische Informationen sicher ausgetauscht werden.
Incident Response nicht nur beschreiben, sondern üben
Ein Incident-Response-Plan muss im Ernstfall unter Zeitdruck funktionieren. Beschreibe deshalb klare Rollen: Wer bewertet den Vorfall? Wer darf Systeme isolieren? Wer informiert Geschäftsleitung, Datenschutz, Fachbereiche oder externe Partner? Wer dokumentiert Entscheidungen?
Ein einfacher Ablauf kann so aussehen:
- Ereignis erkennen und erste Fakten sichern.
- Schweregrad und betroffene Services bewerten.
- Ausbreitung begrenzen, etwa durch Sperren von Konten oder Segmentierung.
- Beweise und Protokolle sichern, ohne die Analyse zu zerstören.
- Ursache beseitigen und Systeme kontrolliert wiederherstellen.
- Betroffene Stellen nach dem festgelegten Meldeweg einbinden.
- Vorfall auswerten und technische Maßnahmen nachziehen.
Übe diesen Ablauf als Tabletop-Szenario und möglichst auch technisch. Simuliert beispielsweise ein kompromittiertes Admin-Konto oder eine Verschlüsselung eines Fileservers. Dabei fallen oft Lücken auf: fehlende Kontaktdaten, unklare Entscheidungsrechte, ungetestete Wiederherstellungen oder fehlende Logs.
Welche Fähigkeiten dein Team gezielt aufbauen sollte
NIS2 umzusetzen ist Teamarbeit zwischen Administration, Netzwerk, Cloud, Entwicklung, Informationssicherheit und Führung. Für Admin-Teams sind besonders diese Kompetenzen relevant:
- Windows- und Linux-Härtung sowie Rechteverwaltung
- Netzwerksegmentierung, Firewall-Regeln und sichere Fernzugänge
- Identitätsmanagement, MFA und privilegierter Zugriff
- Patchmanagement für Betriebssysteme, Anwendungen und Infrastruktur
- Backup, Disaster Recovery und Wiederherstellungstests
- Log-Analyse, Monitoring und technische Forensik-Grundlagen
- Incident Response und verständliche Betriebsdokumentation
Schulungen sind besonders wirksam, wenn ihr eigene typische Szenarien mitbringt: eure Rollenmodelle, eure Backup-Architektur oder eure Alarmmeldungen. In unseren Präsenztrainings in München arbeiten wir deshalb praxisnah an Technologien und Betriebsaufgaben, die du direkt in deinen Alltag übertragen kannst. Passende Seminare und Termine findest du bei uns auf cmt.de.
Die Praxis-Checkliste für den nächsten Teamtermin
Nimm dir mit deinem Team zuerst nicht alles gleichzeitig vor. Prüft, welche Grundlagen bereits vorhanden sind und wo das größte Risiko liegt.
- Asset-Inventar auf Aktualität, Verantwortlichkeiten und Abhängigkeiten prüfen
- MFA für privilegierte und externe Zugriffe priorisieren
- Patchprozess mit festen Bewertungen, Tests und Ausnahmen dokumentieren
- Wiederherstellung eines kritischen Services praktisch testen
- Zentrale Logs und Alarmwege für relevante Sicherheitsereignisse prüfen
- Lieferanten-Zugriffe inventarisieren, begrenzen und regelmäßig kontrollieren
- Incident-Response-Ablauf mit realistischem Szenario üben
- Offene Maßnahmen mit Verantwortlichen, Fristen und Nachweisen verfolgen
So wird aus einer abstrakten Anforderung ein belastbarer Sicherheitsbetrieb. Entscheidend ist nicht das perfekte Konzept auf dem Papier, sondern dass du und dein Team Systeme, Zugriffe und Störungen im Alltag kontrolliert beherrschen.
Nächster Schritt
Passenden Kurs zu IT-Security finden.
Feste Termine, erfahrene Trainer, Präsenz in München und Durchführungsgarantie. Buchen kannst du direkt auf cmt.de.
Weiterlesen