IT-Security
Microsoft Sentinel und Defender XDR lernen: SIEM für den SOC-Alltag
Microsoft Sentinel und Defender XDR lernen: So baust du einen praxisnahen SOC-Workflow für Erkennung, Untersuchung und Reaktion auf.
 KI-generiert
Montagmorgen, kurz nach neun: Im Security-Postfach liegen neue Meldungen zu verdächtigen Anmeldungen, ein Endpoint-Alarm wurde eskaliert und im SIEM erscheinen mehrere Hinweise auf ungewöhnlichen Datenverkehr. Jede Meldung für sich wirkt beherrschbar. Zusammen fehlt jedoch der Überblick: Gehören die Alarme zusammen, ist ein Konto kompromittiert und wer übernimmt welchen nächsten Schritt? Genau an diesem Punkt müssen Microsoft Sentinel und Defender XDR nicht nur technisch aktiviert sein, sondern einen klaren SOC-Workflow unterstützen.
Microsoft Sentinel ist die zentrale SIEM-Plattform für Logdaten, Korrelation, Erkennung und automatisierte Reaktionen. Defender XDR führt Sicherheitsinformationen aus Microsoft-Schutzdiensten zusammen und erleichtert die Untersuchung über Endgeräte, Identitäten, E-Mails, Anwendungen und weitere Signale hinweg. Richtig kombiniert helfen beide Werkzeuge dir dabei, aus einzelnen Alerts nachvollziehbare Sicherheitsvorfälle zu machen.
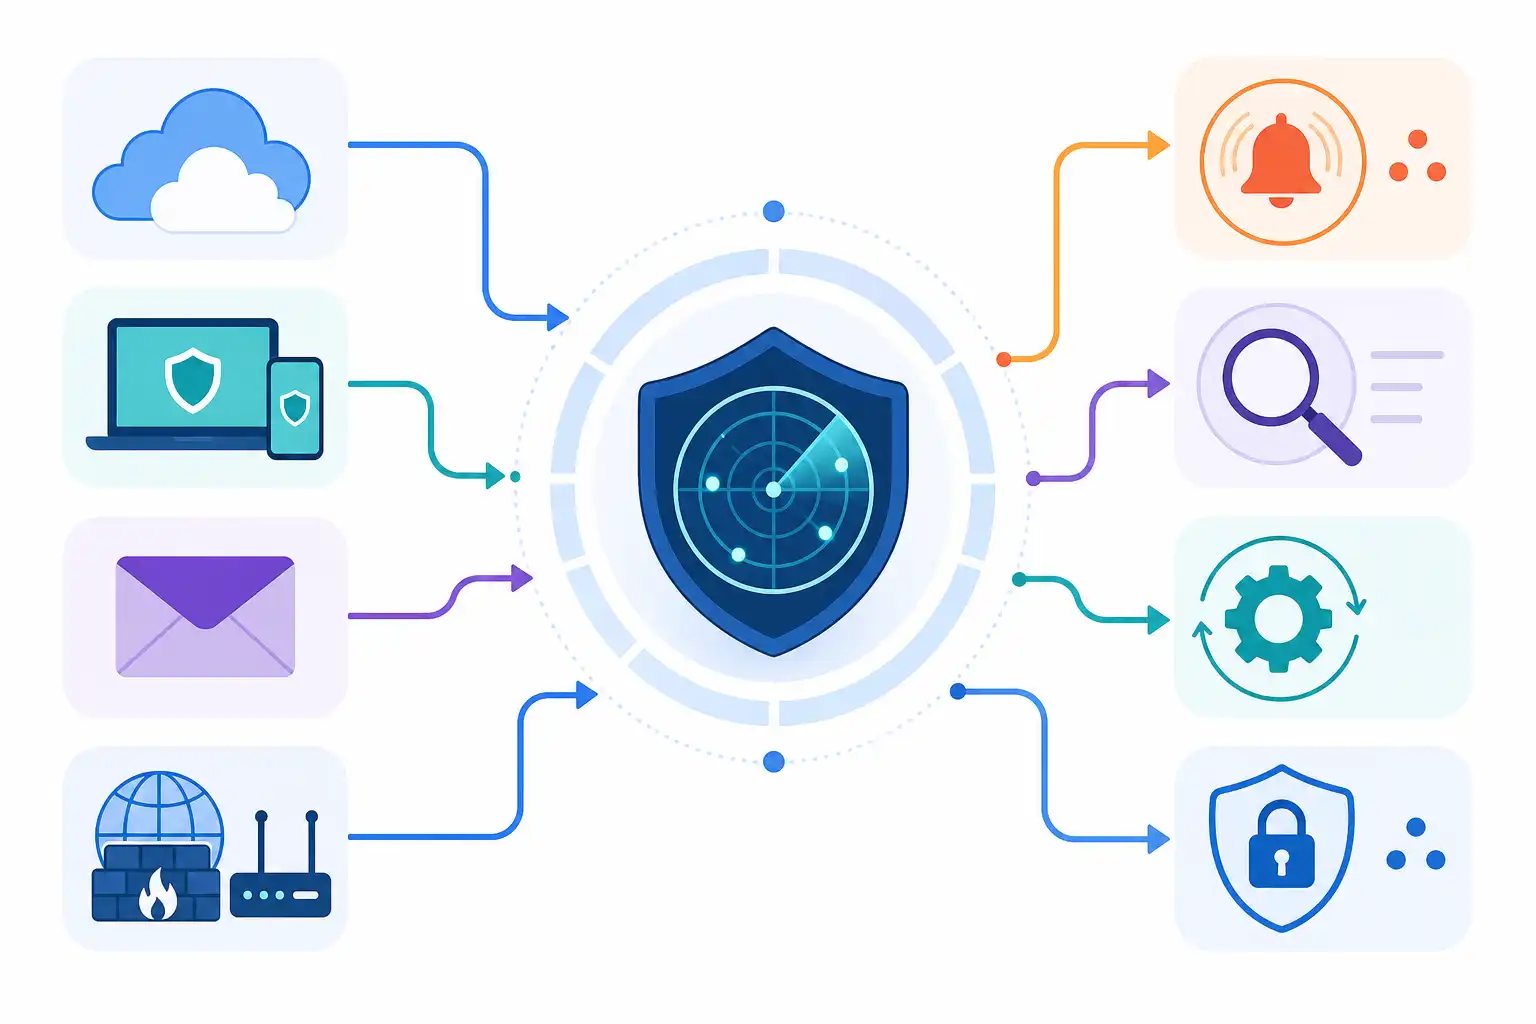
Infografik zu Microsoft Sentinel und Defender XDR lernen: SIEM für den SOC-Alltag (KI-generiert).
Warum ein SIEM allein noch keinen guten SOC-Prozess schafft
Viele Teams starten mit Datenanbindung und Erkennungsregeln. Das ist sinnvoll, führt aber schnell zu einem bekannten Problem: Die Anzahl der Alarme steigt schneller als die Fähigkeit, sie sauber zu bewerten. Ein SOC wird nicht dadurch besser, dass es möglichst viele Warnungen erzeugt. Es wird besser, wenn relevante Vorfälle früh erkennbar sind, Untersuchungsschritte reproduzierbar ablaufen und Reaktionen kontrolliert erfolgen.
Microsoft Sentinel liefert dafür unter anderem:
- zentrale Sammlung und Auswertung sicherheitsrelevanter Logdaten
- Analyse über Kusto Query Language, kurz KQL
- Analyseregeln für Korrelationen und bekannte Angriffsmuster
- Incident-Verwaltung und Fallbearbeitung
- Automatisierung über Playbooks
- Übersichten für Betrieb, Analyse und Reporting
Defender XDR ergänzt diese Fähigkeiten mit einer gemeinsamen Sicht auf Sicherheitsereignisse aus den angebundenen Defender-Produkten. Statt etwa einen verdächtigen Prozess isoliert auf einem Endgerät zu betrachten, kannst du den Bezug zu einer auffälligen Anmeldung, einer Phishing-E-Mail oder einer verdächtigen OAuth-Anwendung prüfen.
Für den SOC-Alltag zählt dabei weniger, in welchem Portal ein Signal zuerst erscheint. Entscheidend ist, dass dein Team die Zusammenhänge erkennt und eine einheitliche Bearbeitungslogik nutzt.
Sentinel und Defender XDR sinnvoll zusammendenken
Die Verbindung beider Plattformen beginnt nicht mit einem Klick im Portal, sondern mit einer Architekturentscheidung. Du solltest festlegen, welche Datenquellen du in Sentinel zentral auswertest, welche Signale Defender XDR bereits gut korreliert und wo dein Team Incidents verbindlich bearbeitet.
Defender XDR ist besonders stark, wenn Microsoft-Sicherheitsprodukte bereits breit genutzt werden. Dazu gehören beispielsweise der Schutz von Endgeräten, Identitäten, E-Mails und Cloud-Anwendungen. Sentinel erweitert diesen Blick um weitere Logquellen, etwa Firewalls, Netzwerkkomponenten, Linux-Systeme, Cloud-Dienste oder Anwendungen aus anderen Herstellern.
| Fragestellung | Defender XDR | Microsoft Sentinel |
|---|---|---|
| Was passiert auf Endgeräten, mit Identitäten oder E-Mails? | Tiefe Untersuchung im Microsoft-Sicherheitskontext | Ergänzende Korrelation mit weiteren Datenquellen |
| Wie erkenne ich Zusammenhänge über verschiedene Systeme? | Korrelation innerhalb angebundener Defender-Signale | Flexible Korrelation mit KQL und Analytics Rules |
| Wie bearbeitet das Team Vorfälle? | Einheitliche Incident-Sicht und Untersuchungsdaten | Incident-Management, Triage und Automatisierung |
| Wie binde ich Drittanbieter und eigene Logs ein? | Je nach Produkt und Integration begrenzt | Zentraler Ansatz für viele Datenquellen |
Die konkrete Oberfläche und verfügbare Integration können sich ändern. Deshalb vermitteln wir in unseren Trainings nicht nur Klickwege, sondern vor allem die dahinterliegende Arbeitsweise: Datenquelle bewerten, Erkennung formulieren, Alarm testen, Incident untersuchen und Reaktion absichern.
Alarmfluten reduzieren: Erst Use Cases, dann Regeln
Eine Alarmflut entsteht häufig, wenn Regeln ohne Priorisierung, Kontext und Verantwortlichkeit aktiviert werden. Standardregeln können ein guter Ausgangspunkt sein. Sie passen aber nicht automatisch zu deiner Umgebung, deinen Kontenmodellen oder deinen Betriebszeiten.
Starte deshalb nicht mit der Frage: „Welche Regeln kann ich noch einschalten?“ Frage stattdessen: „Welche Angriffe oder Fehlkonfigurationen müssen wir zuverlässig erkennen?“
Für einen praxisnahen Einstieg eignen sich Use Cases wie diese:
- Ungewöhnliche Anmeldungen bei privilegierten Konten
- Mehrfache fehlgeschlagene Anmeldungen mit anschließendem Erfolg
- Verdächtige Postfachregeln oder ungewöhnliche E-Mail-Weiterleitungen
- Ausführung auffälliger Prozesse auf Endgeräten
- Hinweise auf Credential Dumping, laterale Bewegung oder Manipulation von Sicherheitswerkzeugen
- Datenabfluss über unerwartete Cloud-Dienste oder Netzwerkziele
- Änderungen an besonders kritischen Rollen, Gruppen oder Richtlinien
Jeder Use Case braucht mehr als eine Detection Rule. Dokumentiere mindestens, welche Datenquellen erforderlich sind, wer den Alarm bearbeitet, welche Informationen zur Triage nötig sind und wann eskaliert wird. So verhinderst du, dass ein Alarm zwar technisch korrekt, aber operativ nicht handhabbar ist.
Eine Regel ist erst nach dem Test produktionsreif
Bei jeder neuen Erkennungsregel solltest du drei Fragen beantworten können:
- Löst die Regel bei einem kontrollierten Test wie erwartet aus?
- Liefert der Alarm genug Kontext für eine schnelle Ersteinschätzung?
- Gibt es bekannte legitime Aktivitäten, die zu Fehlalarmen führen?
Ein Beispiel: Eine Regel erkennt erfolgreiche Anmeldungen nach vielen Fehlversuchen. Das kann auf Passwortangriffe hindeuten. Es kann aber auch durch einen falsch gespeicherten Dienstzugang oder ein Gerät mit veralteten Anmeldedaten entstehen. Ergänze deshalb Kontext wie Kontoart, Quelle, Zielsystem, Zeitraum und bekannte Ausnahmen. Eine Ausnahme darf dabei nicht pauschal einen ganzen Bereich ausblenden, sondern sollte so eng wie möglich formuliert sein.
Triage im SOC: Vom Alert zum belastbaren Incident
Der wichtigste Lernschritt für Admins und Security-Teams ist die Trennung zwischen Alert und Incident. Ein Alert ist ein Hinweis. Ein Incident ist ein bearbeitungswürdiger Sicherheitsfall, der aus einem oder mehreren zusammenhängenden Hinweisen bestehen kann.
Eine gute Triage muss schnell sein, aber nicht oberflächlich. Im ersten Schritt geht es nicht darum, jeden technischen Aspekt zu verstehen. Du willst entscheiden, ob der Fall geschlossen, beobachtet, weiter untersucht oder sofort eingedämmt werden muss.
Arbeite dafür mit einer festen Reihenfolge:
- Prüfe die Priorität, die betroffenen Assets und den Zeitpunkt.
- Kläre, ob privilegierte Konten, kritische Systeme oder sensible Daten betroffen sind.
- Sieh dir die zugehörigen Entitäten an, etwa Benutzer, Geräte, IP-Adressen, Dateien und Anwendungen.
- Vergleiche das Verhalten mit bekannten normalen Aktivitäten.
- Suche in Defender XDR nach Prozessketten, Anmeldeereignissen, E-Mail-Bezug oder weiteren betroffenen Geräten.
- Dokumentiere deine Einschätzung, die Belege und die nächsten Schritte direkt am Incident.
- Weise den Fall klar zu oder eskaliere nach festgelegten Kriterien.
Diese Reihenfolge schafft Verlässlichkeit, besonders wenn mehrere Personen im Wechsel arbeiten. Sie verhindert auch, dass wichtige Informationen nur in Chat-Nachrichten oder im Kopf einzelner Spezialisten bleiben.
Untersuchung mit KQL: Fragen stellen statt Logdaten durchsuchen
KQL ist für Sentinel-Anwender ein zentraler Baustein. Du nutzt die Abfragesprache, um Hypothesen zu prüfen, Auffälligkeiten einzugrenzen und Zusammenhänge sichtbar zu machen. Dafür musst du nicht sofort komplexe Abfragen schreiben können. Wichtiger ist, strukturiert vorzugehen.
Beginne bei einem Incident mit einer klaren Frage:
- Welche Anmeldungen gab es für dieses Konto im relevanten Zeitraum?
- Auf welchen Geräten wurde diese Datei gesehen?
- Welche Prozesse starteten vor und nach dem auffälligen Ereignis?
- Welche externen Ziele kontaktierte das betroffene Gerät?
- Welche weiteren Benutzer oder Systeme nutzen dieselbe IP-Adresse?
Für gute Abfragen brauchst du ein Verständnis der Datenstruktur. Welche Tabelle enthält das Ereignis? Welche Felder liefern Benutzername, Gerät, Zeitstempel oder IP-Adresse? Sind Werte einheitlich formatiert? Gerade bei Daten aus unterschiedlichen Quellen sind diese Fragen entscheidend.
Im Training üben wir deshalb nicht nur Syntax, sondern auch Analysewege. Du lernst, eine Untersuchung von einer Entität aus zu erweitern, Zeiträume sinnvoll zu wählen und Ergebnisse für andere Teammitglieder nachvollziehbar aufzubereiten.
Automatisierung: Wiederholbares beschleunigen, riskantes absichern
Playbooks können im Sentinel-Betrieb viel Zeit sparen. Sie eignen sich vor allem für klar definierte, wiederkehrende Aufgaben. Beispiele sind das Anreichern eines Incidents mit Zusatzinformationen, das Erstellen eines Tickets oder das Benachrichtigen eines Bereitschaftsteams.
Auch Reaktionen können automatisiert werden, etwa wenn ein eindeutig schädlicher Indikator vorliegt. Hier ist jedoch Vorsicht angebracht. Eine automatische Kontosperrung oder Geräteisolierung kann den Angriff stoppen, aber auch den Geschäftsbetrieb beeinträchtigen. Solche Maßnahmen brauchen klare Bedingungen, getestete Abläufe und Verantwortlichkeiten.
Eine hilfreiche Einteilung ist:
- Vollautomatisch: Informationen anreichern, Tickets erzeugen, Prioritäten ergänzen.
- Mit Freigabe: Konto sperren, Gerät isolieren, E-Mail entfernen.
- Manuell: Maßnahmen mit hohem Betriebsrisiko oder unklarer Beweislage.
Automatisierung ersetzt keine Analyse. Sie schafft Freiraum dafür, dass dein Team sich auf Fälle konzentriert, bei denen Erfahrung und Bewertung nötig sind.
Checkliste für einen handhabbaren SOC-Workflow
Bevor du neue Datenquellen, Regeln oder Playbooks produktiv setzt, prüfe diese Punkte:
- Die geschäftskritischen Systeme, Konten und Daten sind bekannt.
- Für jeden priorisierten Use Case gibt es eine verantwortliche Rolle.
- Datenquellen liefern ausreichende und nachvollziehbare Ereignisse.
- Analyseregeln wurden mit realistischen Testfällen geprüft.
- Schweregrade und Eskalationskriterien sind im Team abgestimmt.
- Jeder Incident enthält Bearbeitungsnotizen und eine klare Zuständigkeit.
- Playbooks sind getestet und ihre Berechtigungen sind nachvollziehbar begrenzt.
- Wiederkehrende Fehlalarme werden analysiert, nicht nur geschlossen.
- Erkenntnisse aus bearbeiteten Incidents fließen in Regeln und Prozesse zurück.
Was du in einer praxisnahen Weiterbildung lernen solltest
Ein guter Einstieg in Microsoft Sentinel und Defender XDR verbindet Konfiguration mit echter Fallbearbeitung. Reine Produktüberblicke reichen nicht aus, wenn du später Alarme bewerten, Abfragen schreiben und sichere Entscheidungen treffen musst.
Bei uns arbeitest du deshalb an typischen SOC-Szenarien: Datenquellen einordnen, Erkennungen anpassen, Incidents untersuchen, KQL-Abfragen entwickeln und automatisierte Abläufe bewerten. Dabei sprechen wir auch über Grenzen der Technik, etwa unvollständige Telemetrie, fehlenden Kontext oder riskante Automatismen.
Passende Seminare und Termine findest du bei uns auf cmt.de. Unsere IT-Security-Trainings bieten wir überwiegend als Präsenz-Training in München an, bei Bedarf auch live-online, hybrid oder als Inhouse-Format für dein Team.
Wenn Sentinel und Defender XDR nicht als getrennte Werkzeuge, sondern als Teile eines gemeinsamen Arbeitsablaufs verstanden werden, entsteht ein SOC, das Alarme nicht nur sammelt. Es erkennt Zusammenhänge, priorisiert Risiken und reagiert nachvollziehbar.
Nächster Schritt
Passenden Kurs zu IT-Security finden.
Feste Termine, erfahrene Trainer, Präsenz in München und Durchführungsgarantie. Buchen kannst du direkt auf cmt.de.
Weiterlesen